
ไม่มี GPU ก็รัน LLM ใหญ่ได้? Dell R720 อายุ 14 ปีลองให้ดู
เวลาเริ่มคุยเรื่อง Local LLM รุ่นใหญ่ คำแรก ๆ ที่มักตามมาคือ “VRAM เท่าไร?” เพราะยิ่ง Model ใหญ่ ก็ยิ่งต้องการ Memory Capacity มากพอที่จะเก็บ Model ไว้ระหว่าง Inference
แต่ MattMo ลองตั้งคำถามกลับ: ถ้าไม่ใช้ GPU เลย แล้วเอา Server Enterprise รุ่นเก่า ที่มี System RAM เยอะมากมาแทนล่ะ?
ผลคือ Dell PowerEdge R720 อายุประมาณ 14 ปี ที่ไม่มี Discrete GPU สามารถรัน GLM 5.3 Flash, Qwen 3.8 Flash และ Qwen 3.8 27B ได้ ด้วย Dual Xeon และ DDR3 System Memory 348 GB
แต่มีเงื่อนไขใหญ่: รันได้ ไม่ได้แปลว่ารันได้เร็ว เพราะ Hackaday รายงานว่า ความเร็วสูงสุดอยู่ราว 4 tokens/s
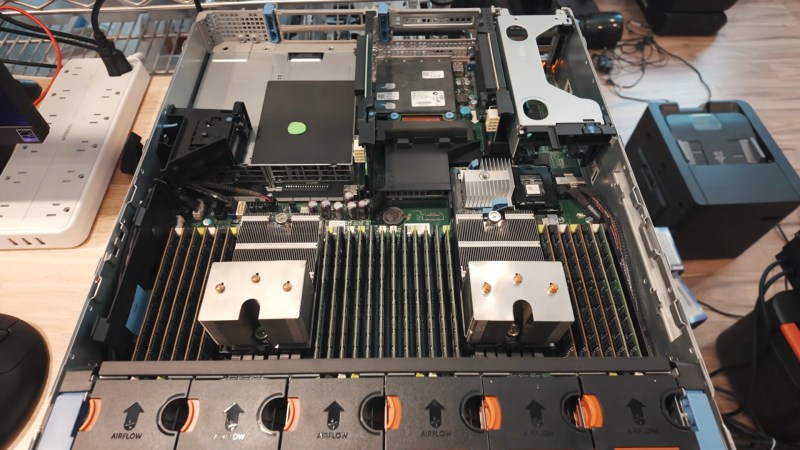
- เครื่องทดลองคือ Dell PowerEdge R720 อายุประมาณ 14 ปี
- ไม่มี Discrete GPU
- ใช้ Dual Xeon และมี 20 Threads รวม ตาม Hackaday
- มี DDR3 System Memory 348 GB
- Hackaday ระบุว่าสามารถรัน GLM 5.3 Flash, Qwen 3.8 Flash และ Qwen 3.8 27B ได้
- ความเร็วสูงสุดที่รายงานอยู่ราว 4 tokens/s ไม่ใช่ 4 tokens/s ของทุกโมเดลแบบแยกรายตัว
- จุดแข็งคือ Memory Capacity มากพอสำหรับ Model ใหญ่ ไม่ใช่ความเร็ว
- Use Case ที่ผู้สร้างมองว่ายังมีเหตุผลคือ Batch Processing และ Homelab ที่มี Hardware อยู่แล้ว
- Hardware มือสองถูกประเมินไว้ประมาณ US$600 ณ ช่วงที่ทำวิดีโอ แต่ไม่ใช่ราคาตายตัว
- Source ไม่ได้ระบุ CPU SKU, Quantization, Runtime, RAM Usage ต่อ Model หรือ Power Consumption
ทำไม Local LLM ถึงพูดถึง VRAM กันตลอด?
เวลาใช้ GPU รัน LLM Model Weights และข้อมูลที่จำเป็นต่อ Inference มักต้องอยู่ใน Memory ที่ GPU เข้าถึงได้รวดเร็ว จึงทำให้คำว่า VRAM กลายเป็นข้อจำกัดสำคัญของ Local AI
ถ้า Model ใหญ่เกิน Memory เราต้องหาวิธีลดขนาด, แบ่ง Model, Offload หรือเปลี่ยน Hardware ตาม Runtime ที่ใช้งาน
Experiment นี้เลือกอีกทาง: ตัด GPU ออกไปเลย แล้วใช้ System RAM จำนวนมากเป็น Memory Pool หลักแทน
Experiment นี้ใช้ Hardware อะไร?
| ส่วนประกอบ | ข้อมูลที่ยืนยันได้จาก Source |
|---|---|
| Server | Dell PowerEdge R720 |
| อายุ | ประมาณ 14 ปีตาม Hackaday |
| CPU | Dual Xeon — Source ไม่ได้ระบุ SKU |
| Threads | 20 Threads รวม ตาม Hackaday |
| System RAM | 348 GB DDR3 |
| Discrete GPU | ไม่มี |
| LLM Throughput | สูงสุดประมาณ 4 tokens/s ตามที่ Hackaday รายงาน |
Dell PowerEdge R720 เป็น Server แบบไหน?
PowerEdge R720 เป็น 2-socket Enterprise Server ที่ Dell ออกแบบมาให้รองรับ Xeon E5-2600 Series และ Memory Configuration ขนาดใหญ่
Dell Documentation ระบุว่า Platform มี:
- Processor Socket สูงสุด 2 ตัว
- รองรับ Intel Xeon E5-2600 / E5-2600 v2 Family
- 24 DIMM Sockets
- DDR3 ECC Memory
- Memory Speed ขึ้นกับ CPU, DIMM และ Configuration
นี่อธิบายได้ว่าทำไม Server เก่าแบบนี้ ถึงน่าสนใจสำหรับ Experiment: มันไม่ได้มี Compute Accelerator รุ่นใหม่ แต่มีพื้นที่ให้ติดตั้ง System Memory จำนวนมากกว่าคอมพิวเตอร์ทั่วไป
348 GB DDR3 ช่วยอะไร ถ้าไม่มี GPU?
หลักคิดง่ายที่สุดคือ: Model ต้องมีที่อยู่ใน Memory ก่อนที่จะถูกประมวลผลได้
ใน GPU Setup ทั่วไป:
แต่ใน Experiment นี้:
Hackaday ระบุว่า Model ถูกเก็บอยู่ใน 348 GB ของ System Memory ทำให้เครื่องสามารถโหลด Model ที่ใหญ่เกินกว่า VRAM ของ GPU Consumer ทั่วไปหลายใบได้ โดยไม่ต้องมี GPU อยู่ในระบบ
Memory Capacity กับ Inference Speed เป็นคนละเรื่อง
นี่คือ Key Insight ของ Experiment ทั้งหมด:
Compute + Memory Performance ช่วยตอบคำถามว่า “แล้วมันสร้างคำตอบได้เร็วแค่ไหน?”
Dell เครื่องนี้ชนะโจทย์แรก เพราะมี RAM 348 GB
แต่โจทย์ที่สองยังหนัก: Hackaday รายงาน Throughput สูงสุด เพียงประมาณ 4 tokens/s
ดังนั้นการบอกว่า:
จะกว้างเกินไป
ประโยคที่ถูกกว่าคือ:
Model อะไรบ้างที่ถูกนำมาทดลอง?
Hackaday ระบุ 3 Model:
| Model ที่ Hackaday ระบุ | ข้อมูลที่ควรรู้ |
|---|---|
| GLM 5.3 Flash | โมเดลขนาดใหญ่มากจาก Z.ai; Official repository ปัจจุบันแสดง GLM-5.3-Flash เป็นโมเดลระดับหลายแสนล้าน Parameters |
| Qwen 3.8 Flash | Hackaday ใช้ชื่อนี้ แต่ Source ของ Experiment ไม่ได้ระบุ Exact Artifact / Quantization Filename |
| Qwen 3.8 27B | Official Qwen repository มี Qwen3.8-27B |
แล้ว Qwen “Flash” รุ่นไหนกันแน่?
Hackaday ใช้ชื่อ “Qwen 3.8 Flash” แต่ไม่ได้ให้ชื่อ Repository, Model Filename หรือ Quantization Artifact ที่ใช้ใน Test
ดังนั้นในบทความนี้ จะรักษาชื่อที่ Hackaday ใช้ และไม่ฟันธง Variant เพิ่มจากการคาดเดา
ประมาณ 4 tokens/s หมายความว่าอย่างไร?
Hackaday เขียนว่า: ประมาณ 4 tokens/s คือความเร็วสูงสุดที่เห็น
Token ไม่ได้เท่ากับคำภาษาไทยหรือภาษาอังกฤษแบบ 1:1 จึงไม่ควรแปลง 4 tokens/s ไปเป็น “กี่คำต่อวินาที” โดยไม่มี Tokenizer และข้อความจริงประกอบ
สิ่งที่บอกได้คือ: ถ้าต้องการ Chat แบบ Interactive ที่คำตอบไหลต่อเนื่องเร็วมาก เครื่องนี้ไม่ใช่ตัวอย่างของความเร็วระดับนั้น
4 tokens/s ช้าไหม? ช้า — แต่ไม่ได้แปลว่าไม่มี Use Case
MattMo เสนอว่าระบบแบบนี้ ยังมีความหมายกับงานประเภท Batch Processing
ตัวอย่างเชิงแนวคิดคือ Workload ที่ไม่ได้มีคนรอคำตอบแบบ Real-time:
- งานประมวลผลเป็น Queue
- งานที่ปล่อยให้ Server ทำต่อเนื่อง
- การทดลอง Model ใน Homelab
- งานที่ Hardware มีอยู่แล้วและไม่ต้องซื้อ GPU เพิ่ม
สำหรับ Interactive Assistant Source เองก็ไม่แนะนำให้คาดหวัง ประสบการณ์แบบระบบ AI สมัยใหม่ที่ตอบเร็วมาก
ทำไม Dual Xeon ยังช้า?
Hackaday ชี้ข้อจำกัดหลัก ที่เห็นจาก Experiment ไว้สองอย่าง:
- มีเพียง 20 Threads รวมระหว่าง CPU สองตัว
- Processor เก่าจนขาด Instruction บางชนิดที่อาจช่วยเร่ง Inference
สิ่งที่เห็นได้ชัดจากผลลัพธ์คือ Large RAM Capacity ช่วยให้ Model โหลดได้ แต่ CPU Compute Capability ยังจำกัดอัตราการสร้าง Token
แล้ว Memory Bandwidth ล่ะ?
Dell R720 เป็น DDR3 Platform และ Dell ระบุ Memory Speed หลายระดับ ตาม CPU / DIMM / Configuration
แต่ Experiment ไม่ได้ให้:
- DIMM Layout
- Memory Speed ที่ใช้งานจริง
- NUMA Placement
- Measured Memory Bandwidth
- Bandwidth Utilization
ดังนั้นจะไม่สร้างตัวเลข “Memory Bottleneck = XX GB/s” ขึ้นเอง
สิ่งที่ Source ไม่ได้บอก แต่สำคัญมากถ้าจะทำตาม
ข่าวนี้พิสูจน์ Concept ได้ดี แต่ยังไม่ใช่ Step-by-step Build Guide
| ข้อมูล | สถานะ |
|---|---|
| Exact Xeon SKU | Source ไม่ได้ระบุ |
| CPU Clock | Source ไม่ได้ระบุ |
| DIMM จำนวน / Layout | Source ไม่ได้ระบุ |
| DDR3 Speed จริงของเครื่อง | Source ไม่ได้ระบุ |
| Operating System | Main Source ไม่ได้ระบุ |
| Inference Runtime | Source ที่ให้มาไม่ได้ระบุ |
| Quantization / Weight Format | Source ไม่ได้ระบุ |
| RAM Usage ต่อ Model | Source ไม่ได้ระบุ |
| Context Length ที่ใช้ Test | Source ไม่ได้ระบุ |
| Prompt Processing Speed | Source ไม่ได้ระบุ |
| Per-model Generation TPS | Source ไม่ได้ระบุ |
| Power Consumption | Source ไม่ได้ระบุ |
Server มือสองประมาณ US$600 — ต้องมองอะไรเพิ่มก่อนเรียกว่า “ถูก”?
Hackaday ระบุว่า MattMo ประเมิน Hardware ชุดนี้ไว้ประมาณ US$600 ตามราคาตลาดมือสองช่วงที่ทำวิดีโอ
จุดที่ต้องระวังคือ ตัวเลขนี้เป็น:
ไม่ใช่ราคาตายตัวของ R720 ทุกเครื่อง เพราะ Configuration ต่างกันได้มาก โดยเฉพาะ RAM
และการดู Purchase Cost อย่างเดียวก็ยังตอบไม่ได้ว่า ระบบนี้ “คุ้มกว่า GPU” หรือไม่ เพราะ Source ไม่มี:
- Power Draw
- Electricity Cost
- Cooling Cost
- Tokens per Watt
- Maintenance Cost
- Noise Measurement
CPU-only Local LLM ได้อะไร และเสียอะไร?
| ได้อะไร | ต้องแลกกับอะไร |
|---|---|
| ใช้ System RAM Capacity ขนาดใหญ่ | Inference ช้ากว่าระบบที่มี Accelerator เหมาะสม |
| ใช้ Server เก่าที่บาง Homelab มีอยู่แล้ว | Hardware เก่ามีข้อจำกัดด้าน CPU และ Instruction Support |
| ไม่ต้องมี Discrete GPU | ไม่เหมาะกับ Real-time Interactive Workload เท่าระบบเร็วกว่า |
| สามารถออกแบบ Local Processing Workflow ได้ | ต้องจัดการ Infrastructure และ Runtime เอง |
แล้วเรื่อง Privacy?
เหตุผลหนึ่งที่ Hackaday ยกขึ้นมาตอนพูดถึง Local LLM คือ Privacy
การรัน Inference บน Hardware ของตัวเอง สามารถเปิดทางให้สร้าง Workflow ที่ไม่ต้องส่ง Prompt ไปยัง Cloud Inference Service
แล้ว GPU ยังสำคัญอยู่ไหม?
Experiment นี้ไม่ได้พิสูจน์ว่า GPU “ไม่จำเป็นอีกต่อไป”
สิ่งที่มันพิสูจน์ได้มากกว่าคือ:
แต่ตัวเลขสูงสุดประมาณ 4 tokens/s ก็แสดงให้เห็นพร้อมกันว่า Hardware Acceleration ยังมีคุณค่ามาก เมื่อโจทย์คือ Latency และ Interactive Performance
เพราะฉะนั้นคำถามที่ดีกว่า:
แต่
“Workload นี้ต้องเร็วแค่ไหน และเรามี Memory แบบไหนอยู่แล้ว?”
ดู MattMo ทดสอบ Server อายุ 14 ปีจริง
วิดีโอต้นทางแสดง Experiment การรัน Large LLM บน Dell PowerEdge R720 ที่ไม่มี Discrete GPU
FAQ: รัน Local LLM โดยไม่มี GPU
1. LLM รันโดยไม่มี GPU ได้ไหม?
ได้ในเชิงหลักการและใน Experiment นี้ โดยใช้ CPU และ System RAM แต่ Performance ขึ้นกับ Model, Runtime และ Hardware
2. Server ที่ใช้คือรุ่นอะไร?
Dell PowerEdge R720 ซึ่ง Hackaday เรียกว่าเป็น Server อายุประมาณ 14 ปี
3. มี GPU หรือไม่?
ไม่มี Discrete GPU ใน Experiment ที่ Hackaday รายงาน
4. มี RAM เท่าไร?
348 GB DDR3 System Memory ตาม Hackaday
5. ใช้ CPU รุ่นอะไร?
Source ระบุเพียง Dual Xeon และ 20 Threads รวม แต่ไม่ได้บอก Exact Xeon SKU
6. รัน Model อะไรได้บ้าง?
Hackaday ระบุ GLM 5.3 Flash, Qwen 3.8 Flash และ Qwen 3.8 27B
7. ความเร็วเท่าไร?
Hackaday ระบุว่าประมาณ 4 tokens/s คือความเร็วสูงสุดที่เห็น แต่ไม่ได้ให้ TPS แยกราย Model
8. 4 tokens/s ถือว่าเร็วไหม?
ไม่ใช่ความเร็วสูงสำหรับ Interactive Chat แต่ผู้สร้างมองว่ายังอาจเหมาะกับ Batch-oriented Workload บางประเภท
9. ใช้ RAM แทน VRAM ได้เลยไหม?
System RAM สามารถเป็น Memory สำหรับ CPU-only Inference ได้ แต่ RAM Capacity กับ Performance เป็นคนละเรื่อง
10. ใช้ Quantization แบบไหน?
Source ที่ให้มาไม่ได้ระบุ Exact Quantization หรือ Weight Format ของ Experiment
11. ใช้ Ollama หรือ llama.cpp?
Main Source ที่ให้มาไม่ได้ระบุ Inference Runtime ชัดเจน จึงไม่ควรเดา
12. Server ราคา $600 จริงไหม?
MattMo ประเมิน Hardware มือสอง ประมาณ US$600 ตามราคาช่วงที่ทำวิดีโอ ไม่ใช่ราคาตายตัว
13. ประหยัดไฟกว่า GPU หรือไม่?
Source ไม่ได้ให้ Power Consumption หรือ Tokens per Watt จึงสรุปไม่ได้
14. Server รุ่นนี้ใส่ RAM เยอะได้เพราะอะไร?
Dell PowerEdge R720 เป็น Enterprise Server แบบ 2-socket และมี 24 DIMM Sockets สำหรับ DDR3 ECC Memory
15. นี่แปลว่าไม่ต้องซื้อ GPU สำหรับ Local AI แล้วใช่ไหม?
ไม่ Experiment แสดงเพียงว่า CPU-only Inference สามารถรัน Model ใหญ่ได้ เมื่อมี System Memory เพียงพอ แต่ Throughput ประมาณ 4 tokens/s ยังสะท้อนข้อจำกัดด้าน Performance ชัดเจน
สรุป: Server เก่ารัน LLM ใหญ่ได้ แต่คำสำคัญคือ “ได้” ไม่ใช่ “เร็ว”
Dell PowerEdge R720 เครื่องนี้ ทำสิ่งที่ดูสวนกับภาพจำของ Local AI: ไม่มี GPU เลย แต่ยังโหลดและรัน Large LLM หลายรุ่นได้
เคล็ดลับไม่ได้อยู่ที่ CPU รุ่นเก่า กลายเป็น AI Accelerator ขึ้นมา แต่คือเครื่องมี 348 GB DDR3 System RAM มากพอสำหรับ Model ที่ต้องใช้ Memory จำนวนมาก
สิ่งที่ต้องแลกคือ Speed เพราะ Hackaday รายงานค่าสูงสุดประมาณ 4 tokens/s เท่านั้น
ถ้ามี R720 พร้อม RAM จำนวนมาก นอนอยู่ใน Homelab อยู่แล้ว Experiment นี้แสดงให้เห็นว่า Hardware เก่ายังมีพื้นที่ให้ลองของใหม่ได้
แต่ถ้าจะซื้อระบบใหม่เพื่อ Local AI โดยเฉพาะ แค่เห็น Hardware มือสองประมาณ US$600 ยังไม่พอสำหรับตัดสินใจ: ต้องคิดต่อทั้ง Performance, Power, Runtime, Memory Configuration และลักษณะ Workload ที่เราต้องการจริง
Key Insight สุดท้ายจึงไม่ใช่ “GPU ไม่จำเป็น” แต่คือ:
แต่ถ้าโจทย์คือ “ตอบได้เร็วแค่ไหน” Compute Performance กลับมาสำคัญทันที
อยากดูรายละเอียดการทดลอง แนะนำอ่านและดู Source ต้นฉบับ
ข่าว Hackaday ให้ภาพรวมของ Hardware, Model และ Performance ส่วน Video ของ MattMo เป็น Media หลักของ Experiment
อ่านบทความ No GPU, No Problem บน Hackaday
ดูวิดีโอ Flagship AI On A 14 Year Old Server
References / แหล่งข้อมูลต้นฉบับ
- Hackaday — No GPU, No Problem: Flagship LLMs On A GPU-less Teenaged Server
- YouTube — Flagship AI On A 14 Year Old Server (No GPU)
- Dell — PowerEdge R720 Technical Specifications
- Z.ai / Hugging Face — GLM-5.3-Flash
- Qwen / Hugging Face — Qwen3.8-27B
อยากลอง Local AI หรือ Edge AI ด้วย Hardware ของตัวเอง?
ถ้ากำลังทดลอง Local AI, Edge AI, Development Board หรือสร้าง AI Prototype สามารถสอบถามทีม Globalbyte เรื่องบอร์ดและอุปกรณ์ที่เหมาะกับ Project ได้
จุดเริ่มต้นไม่จำเป็นต้องเป็น Server RAM หลายร้อย GB เสมอไป เพราะ Hardware ที่เหมาะ ขึ้นกับ Model Size, Latency ที่ต้องการ และประเภทงานที่ต้องประมวลผล
Hackaday ระบุว่าระบบทดลองใช้ Dell PowerEdge R720, Dual Xeon, 20 Threads รวม, DDR3 System Memory 348 GB และไม่มี Discrete GPU แต่ Source ไม่ได้ระบุ Exact Xeon SKU บทความนี้จึงไม่ได้เดารุ่น CPU เพิ่มเอง
ตัวเลขประมาณ 4 tokens/s เป็นความเร็วสูงสุดที่ Hackaday รายงานจาก Experiment ไม่ใช่ค่า Benchmark แยกราย Model และไม่ควรนำไปใส่ให้ GLM 5.3 Flash, Qwen 3.8 Flash และ Qwen 3.8 27B ว่าทำได้ 4 tokens/s เท่ากันทั้งหมด
Source ไม่ได้ระบุ Exact Quantization, Weight Format, Inference Runtime, Operating System, Context Length, Prompt Length, Batch Size, Time to First Token, Prompt-processing Speed หรือ RAM Usage แยกราย Model บทความนี้จึงไม่ได้สร้างค่าเหล่านั้นขึ้นเอง
Hackaday ระบุว่า CPU รุ่นเก่า ขาด Instruction บางอย่าง ที่อาจช่วยเพิ่มความเร็ว แต่ไม่ได้ระบุชื่อ Instruction และ Exact CPU SKU จึงไม่ควรฟันธงว่าเป็น AVX2 หรือ Instruction ใดโดยเฉพาะ
Dell ระบุว่า PowerEdge R720 รองรับ DDR3 Memory หลาย Speed ตาม CPU, DIMM และ Configuration แต่ Experiment ไม่ได้ระบุ Actual DIMM Speed, Memory Channel Population, NUMA Placement หรือ Measured Memory Bandwidth บทความนี้จึงไม่ได้สร้าง Memory-bandwidth Benchmark ขึ้นเอง
ราคาประมาณ US$600 เป็น Used-market Estimate ที่ MattMo ให้ไว้ตามช่วงเวลาของวิดีโอ ไม่ใช่ราคาตายตัว และไม่ได้รวมการวิเคราะห์ Electricity Cost, Cooling, Maintenance หรือ Total Cost of Ownership
Source ไม่ได้ให้ Power Consumption, Tokens per Watt หรือ Energy-efficiency Comparison กับ GPU จึงไม่ควรสรุปว่าระบบนี้ ประหยัดไฟหรือประหยัดต้นทุนกว่า GPU โดยอัตโนมัติ
Experiment นี้แสดงว่า Large LLM สามารถรันแบบ CPU-only ได้เมื่อมี System Memory เพียงพอ แต่ไม่ได้พิสูจน์ว่า GPU ไม่มีประโยชน์หรือไม่จำเป็น สำหรับทุก Local AI Workload


